Açık kaynak · MIT Ücretsiz Aktif geliştiriliyor Chatbot

llama.cpp Kurulumu

Ollama ve Jan gibi uygulamaların arkasındaki motor: Dil modellerini en az bağımlılıkla, en ince ayarla çalıştıran açık kaynak C/C++ projesi.

Editör testi: · sürüm 0.7.0 (b11669) 132,2 bin GitHub yıldızı Son sürüm v0.7.0 (15 gün önce)

llama.cpp nedir?

llama.cpp, dil modellerini sıradan bilgisayarlarda çalıştırmak için yazılmış açık kaynak bir C/C++ projesidir. GGUF biçimindeki modelleri işlemcide, NVIDIA ve AMD ekran kartlarında ya da Apple Silicon'da çalıştırır; model ekran kartına sığmazsa bir kısmını işlemciye verir. Ollama, Jan ve LM Studio gibi uygulamaların çoğu arka planda bu motoru kullanır.

Projeyle gelen llama-server, tek komutla hem tarayıcıda açılan bir sohbet arayüzü hem de OpenAI uyumlu bir API başlatır. -hf seçeneğiyle Hugging Face'teki bir modeli adıyla indirip doğrudan çalıştırabilirsiniz. Arayüzde her cevabın hızı (saniyedeki belirteç sayısı) görünür, model yöneticisi ve görsel anlayan modeller için resim yükleme vardır.

Hazır ve kolay bir başlangıç isteyenler için Ollama ya da Jan daha uygundur; ikisi de bu motoru sizin yerinize ayarlar. Donanımından son damlayı almak, yeni çıkan bir modeli ilk gün denemek ya da katman, bağlam ve kuantizasyon ayarlarını kendisi seçmek isteyenler için llama.cpp doğrudan kullanılmaya değer.

Arayüz
Tarayıcıda açılan arayüz
İnternet
Kurulumdan sonra internetsiz çalışır
Kurulum
Orta: Birkaç komut satırı adımı; terminal açmayı bilmek yeter.
Türkçe
Arayüz Türkçe değil. Web arayüzü yalnız İngilizce. Modelle Türkçe yazışabilirsiniz; Gemma 3 4B Türkçe soruları akıcı cevapladı.
Geliştirici
ggml-org (Georgi Gerganov ve topluluk)

Artıları

  • En ince ayar: Katman sayısı, bağlam boyutu, kuantizasyon ve iş parçacığı sayısı tek tek seçilebilir.
  • Model sığmazsa sığan kısmı ekran kartına kendisi yerleştirir.
  • llama-server tek komutla web arayüzü ve OpenAI uyumlu API açar.
  • Windows, macOS ve Linux için CUDA, ROCm, Vulkan, Metal ve işlemci derlemeleri hazır gelir.
  • Yeni model mimarileri çoğunlukla önce llama.cpp'ye gelir; Ollama ve Jan bu motoru kullanır.

Eksileri

  • Komut satırı bilgisi ister; model seçimi ve ayarlar elle yapılır.
  • Linux CUDA derlemesinde cudart paketi eksikse uyarı vermeden işlemciye düşer.
  • Web arayüzü yalnız İngilizce.
  • Sürümler neredeyse her gün çıkar; eski rehberlerdeki port ve komut adları değişmiş olabilir.

Bilgisayarınız yeter mi?

Ekran kartınızı ve belleğinizi seçerek bu projenin bilgisayarınızda nasıl çalışacağını görün.

Donanımımı seç
llama.cpp donanım gereksinimleri
DonanımDestekEn düşükÖnerilen
NVIDIA ekran kartı Linux ve Windows için hazır CUDA derlemesi var; Linux'ta ayrıca cudart paketi gerekir. Model sığmazsa sığan kısmı ekran kartına koyar. Boş 4 GB kartımızda 4 milyar parametreli model tamamen ekran kartındayken saniyede 52 belirteç, yalnız işlemcide 12–13 belirteç üretti. Tam destek — 8 GB VRAM
AMD ekran kartı Linux için ROCm ve Vulkan derlemeleri var. Editörlerimiz AMD'de test etmedi. Tam destek — 8 GB VRAM
Apple Silicon (M serisi) Apple Silicon birinci sınıf destekli (Metal). Model birleşik belleği kullanır. Editörlerimiz Mac'te test etmedi. Tam destek 8 GB RAM 16 GB RAM
Ekran kartı yok (yalnız işlemci) Ekran kartı olmadan da çalışır. 4 milyar parametreli modeli yalnız işlemcide (Ryzen 5 5500U) saniyede 12–13 belirteçle çalıştırdık; okunabilir bir yazı hızı. Tam destek 8 GB RAM 16 GB RAM
  • Sistem belleği en az 8 GB, önerilen 16 GB
  • Disk alanı en az 6 GB
  • -hf seçeneği modeli Hugging Face'ten kendisi indirir; Gemma 3 4B görsel anlama dosyasıyla birlikte 3,2 GB tuttu. Linux CUDA derlemesi cudart paketiyle birlikte 1,1 GB yer kaplar.

Resmî kaynak

GitHub deposunu aç

github.com/ggml-org/llama.cpp

Resmî site

Yazılımı yalnızca bu adreslerden indirin. Sitemiz dosya barındırmaz; bağlantılar doğrudan projenin kendi sayfasına gider.

Hazır derlemeleri yalnız GitHub'daki ggml-org/llama.cpp sürümler sayfasından ya da llama.app adresinden indirin. Modelleri Hugging Face'te güvendiğiniz hesaplardan (ör. ggml-org) alın.


Lisans
MIT
Son sürüm
v0.7.0
Son güncelleme
24 Ekim 2026
GitHub yıldızı
132,2 bin
YZ Lab

Tarayıcıdan kullanın

llama.cpp bilgisayarınızda çalışırken Yerel Sohbet ona doğrudan bağlanır. Ollama, LM Studio, llama.cpp ve Jan'daki modellerle Türkçe sohbet; görsel okuyan modellere görsel de eklenir.

Yerel Sohbet sayfasını açın

Sayfa yalnız arayüzü sunar; verileriniz bilgisayarınızdan çıkmaz. Üyelik gerekmez.

Reklam

Kurulum: Windows, macOS ve Linux'ta

İşletim sisteminizi seçin. Adımları tamamladıkça işaretleyin; ilerlemeniz bu tarayıcıda saklanır, sayfaya döndüğünüzde kaldığınız yerden devam edersiniz.

Windows · winget

0 / 3 adım tamamlandı

Gerekenler: Resmî belgeye göre; editörlerimiz Windows'ta test etmedi. winget paketi her yeni sürümle kendiliğinden güncellenir. İsterseniz sürümler sayfasından CUDA, Vulkan ya da işlemci için hazır zip paketini de indirebilirsiniz.

  1. llama.cpp'yi kurun

    PowerShell'i açıp llama.cpp'yi winget ile kurun.

    PowerShell
    winget install llama.cpp
  2. Bir modelle sunucuyu başlatın

    Yeni bir PowerShell penceresinde sunucuyu bir Hugging Face modeliyle başlatın; model ilk seferde iner.

    PowerShell
    llama-server -hf ggml-org/gemma-3-4b-it-GGUF
  3. Tarayıcıda açın

    Kayıtta "listening on" satırını görünce tarayıcıda http://127.0.0.1:9931 adresini açıp sohbete başlayın.

macOS · Homebrew

0 / 3 adım tamamlandı

Gerekenler: Resmî belgeye göre; editörlerimiz Mac'te test etmedi. Apple Silicon Mac'lerde Metal hızlandırması kendiliğinden açılır. Homebrew kurulu değilse brew.sh adresindeki komutla önce onu kurun.

  1. llama.cpp'yi kurun

    Terminali açıp llama.cpp'yi Homebrew ile kurun.

    Terminal
    brew install llama.cpp
  2. Bir modelle sunucuyu başlatın

    Sunucuyu bir Hugging Face modeliyle başlatın; model ilk seferde iner.

    Terminal
    llama-server -hf ggml-org/gemma-3-4b-it-GGUF
  3. Tarayıcıda açın

    Tarayıcıda http://127.0.0.1:9931 adresini açıp sohbete başlayın.

Linux · Hazır CUDA derlemesi

0 / 5 adım tamamlandı

Gerekenler: Bu adımları Ubuntu 24.04'te NVIDIA RTX 3050 ile test ettik; yönetici yetkisi gerekmez. NVIDIA kartınız yoksa ubuntu-x64 (işlemci) ya da ubuntu-vulkan-x64 paketini indirin; cudart adımına gerek kalmaz. Resmî README'deki tek satırlık betik (curl -LsSf https://llama.app/install.sh | sh) ekran kartınıza uygun derlemeyi ~/.local/bin altına kurar; o yolu test etmedik.

  1. Derlemeyi ve CUDA kütüphanelerini indirin

    Sürümler sayfasından aynı yapı numarasına ait iki paketi indirin: Programın kendisi ve CUDA çalışma kütüphaneleri (cudart). İkincisi olmadan llama.cpp ekran kartını görmez.

    Terminal
    mkdir -p ~/llama.cpp && cd ~/llama.cpp
    curl -LO https://github.com/ggml-org/llama.cpp/releases/download/b11669/llama-b11669-bin-ubuntu-cuda-12.8-x64.tar.gz
    curl -LO https://github.com/ggml-org/llama.cpp/releases/download/b11669/cudart-llama-b11669-bin-ubuntu-cuda-12.8-x64.tar.gz

    b11669, v0.7.0 sürümünün yapı numarasıdır. Daha yeni bir sürüm kullanacaksanız iki paketin numarasının aynı olmasına dikkat edin.

  2. İki paketi aynı klasöre açın

    Paketleri açın; cudart kütüphaneleri programın yanına gelmeli.

    Terminal
    tar -xzf llama-b11669-bin-ubuntu-cuda-12.8-x64.tar.gz
    tar -xzf cudart-llama-b11669-bin-ubuntu-cuda-12.8-x64.tar.gz --strip-components=1 -C llama-b11669
  3. Ekran kartının görüldüğünü doğrulayın

    Cihazları listeleyin. Listede kartınızın adı yoksa cudart paketi eksik ya da sürücü eski demektir.

    Terminal
    ./llama-b11669/llama-cli --list-devices
    Şunu görmelisiniz
    Available devices:
      CUDA0: NVIDIA GeForce RTX 3050 Laptop GPU (3770 MiB, 2668 MiB free)
  4. Sunucuyu bir modelle başlatın

    Sunucuyu Hugging Face'teki bir modelle başlatın. Model ve görsel anlama dosyası (3,2 GB) ilk seferde iner; bizim bağlantımızda 33 saniye sürdü.

    Terminal
    ./llama-b11669/llama-server -hf ggml-org/gemma-3-4b-it-GGUF
    Şunu görmelisiniz
    llama_server: listening on http://127.0.0.1:9931

    Görsel anlama gerekmiyorsa komutun sonuna -ngl 99 -c 4096 --no-mmproj ekleyin; 4 GB kartımızda model tamamen ekran kartına sığdı ve hız saniyede 22,5 belirteçten 52 belirtece çıktı.

  5. Tarayıcıda açın

    http://127.0.0.1:9931 adresini açın, mesaj kutusuna Türkçe yazıp Enter'a basın. Cevabın altındaki hız değeri ayar denemelerinde işinize yarar. Sunucuyu kapatmak için terminalde Ctrl + C.

Reklam

İlk çalıştırma

llama-server başladığında web arayüzü tarayıcınızda http://127.0.0.1:9931 adresinde açılır. Eski rehberlerde geçen 8080 portu v0.7.0 ile 9931 oldu.

  • Sunucuyu -hf seçeneğiyle bir Hugging Face modeliyle başlatın (ör. llama-server -hf ggml-org/gemma-3-4b-it-GGUF). Model ilk seferde iner ve ~/.cache/huggingface altında saklanır; sonraki açılışlarda yeniden inmez.
  • Kayıtta listening on http://127.0.0.1:9931 satırını görünce adresi tarayıcıda açın, mesaj kutusuna Türkçe yazıp Enter'a basın. Her cevabın altında belirteç sayısı, süre ve hız yazar.
  • Sol menüdeki küp simgesi model yöneticisini açar; modelin bağlam boyutunu ve görsel desteğini buradan görebilirsiniz. Gemma 3 gibi görsel anlayan modellerde mesaj kutusundaki artı düğmesiyle resim de gönderebilirsiniz.
  • Hızı artırmak için aynı soruyu farklı ayarlarla deneyin. Görsel anlama gerekmiyorsa --no-mmproj ekran kartında yaklaşık 800 MB yer açar; model artık sığıyorsa -ngl 99 bütün katmanları ekran kartına koyar. 4 GB kartımızda bu ikisiyle hız saniyede 22,5 belirteçten 52 belirtece çıktı. Model çalışırken ekran kartını kullanan uygulamaları (oyun, video, başka yapay zekâ araçları) kapatın.
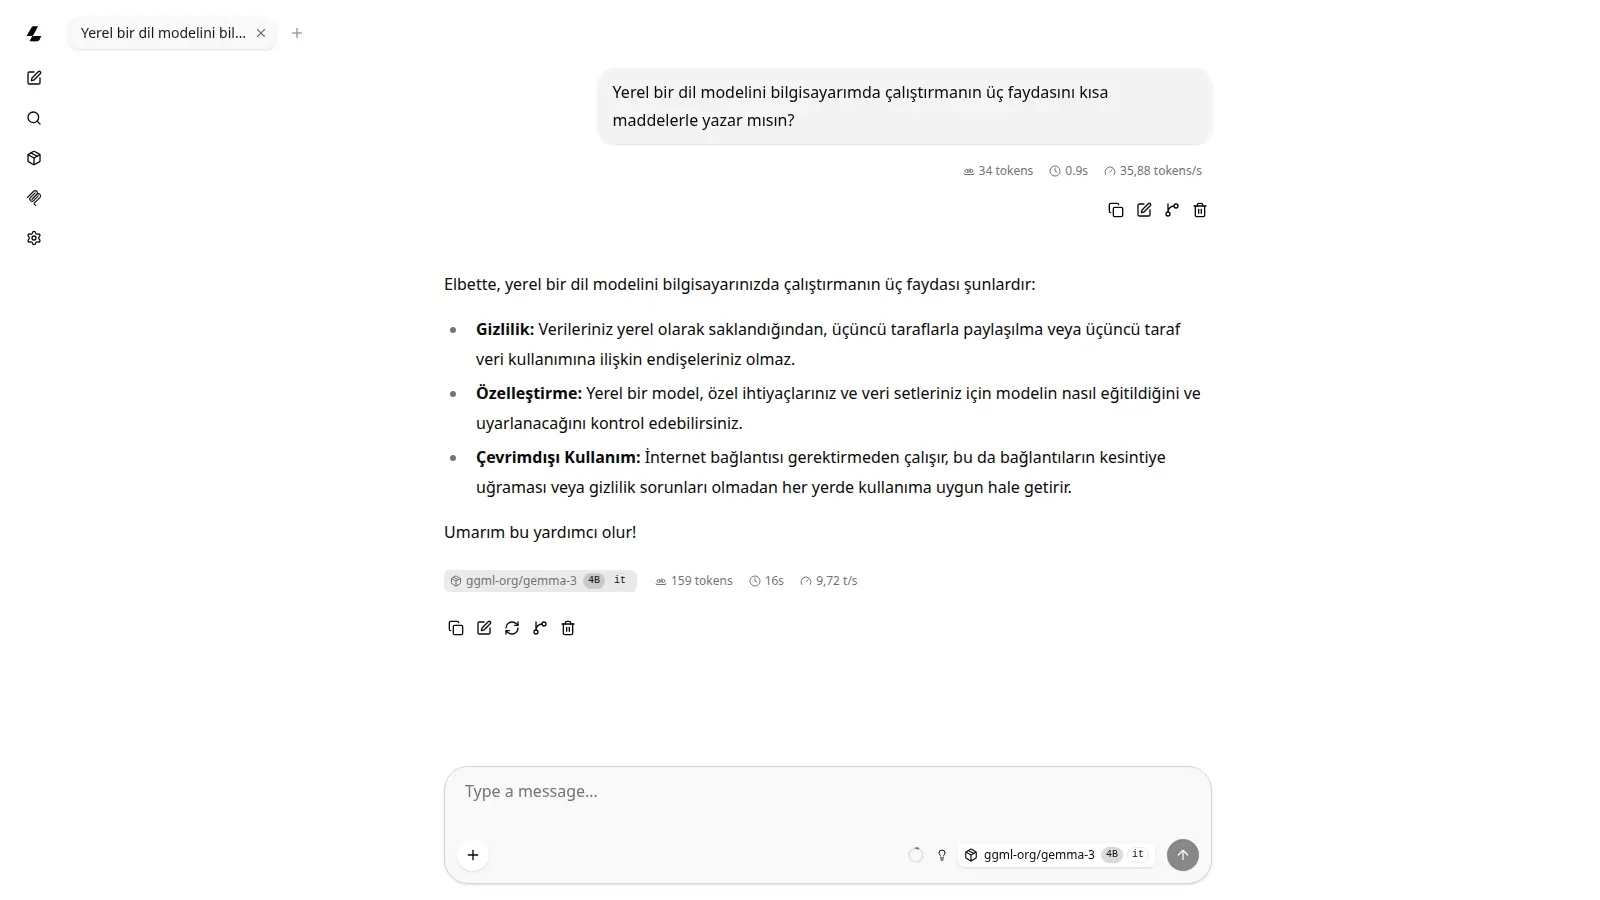
llama-server web arayüzünde Gemma 3 4B ile Türkçe sohbet (kartta başka uygulamalar açıkken saniyede 9,7 belirteç).
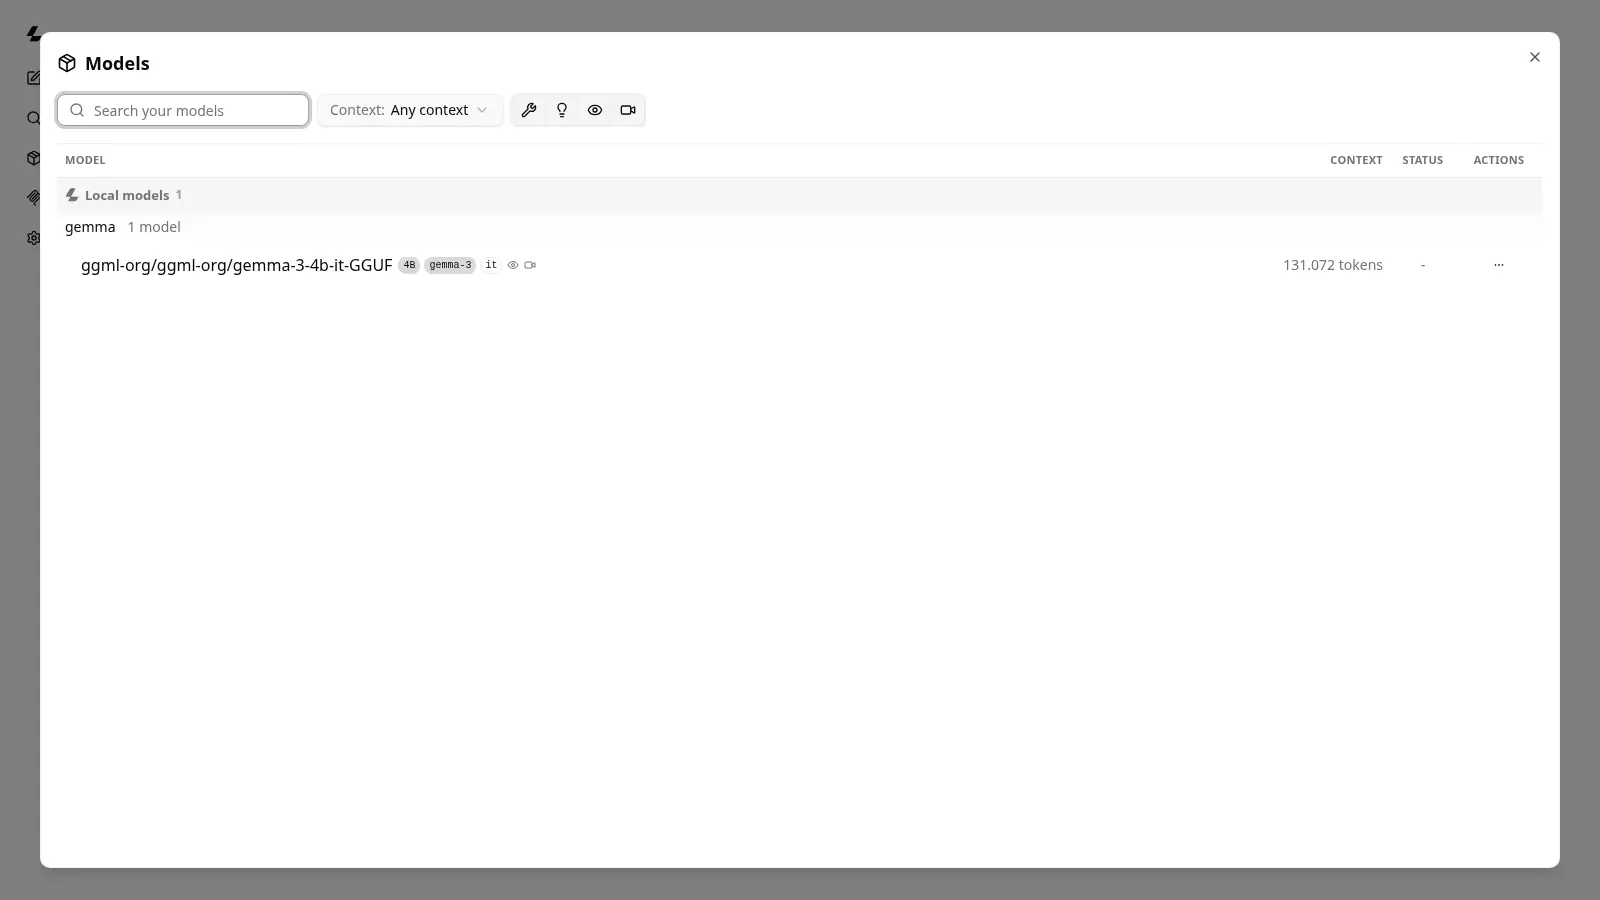
Web arayüzünün model yöneticisi: Hugging Face'ten indirilen model ve bağlam boyutu.

Sorun giderme 3

Ekranda gördüğünüz hata metnine tıklayın; nedeni ve çözümü açılır.

Neden: Linux CUDA derlemesi CUDA çalışma kütüphanelerini (libcudart.so.12, libcublas.so.12) içermiyor. Bunlar yoksa llama.cpp hata vermeden ekran kartını atlar ve işlemcide çalışır.

Çözüm: Sürümler sayfasından aynı yapı numarasının cudart-llama-…-bin-ubuntu-cuda-12.8-x64.tar.gz paketini indirip llama.cpp klasörüne açın, ardından cihazları yeniden listeleyin. Sistemde CUDA Toolkit kuruluysa bu adım gerekmez.

Terminal
tar -xzf cudart-llama-b11669-bin-ubuntu-cuda-12.8-x64.tar.gz --strip-components=1 -C llama-b11669
./llama-b11669/llama-cli --list-devices
Neden: Model, bağlam belleğiyle birlikte ekran kartına sığmıyor. Otomatik yerleştirme kapalıyken (--fit off) bütün katmanları ekran kartına zorlamak 4 GB kartta bu hatayı verdi.

Çözüm: Otomatik yerleştirmeyi açık bırakın (varsayılan) ya da ekran kartına giden katman sayısını -ngl ile düşürün. Görsel anlama gerekmiyorsa --no-mmproj ve küçük bir bağlam boyutu (-c 4096) yer açar; 4 GB kartımızda model böylece tamamen sığdı.

Terminal
llama-server -hf ggml-org/gemma-3-4b-it-GGUF -ngl 99 -c 4096 --no-mmproj

Neden: llama-server API'sini şifresiz açar. Varsayılan adres 127.0.0.1 olduğu için yalnız sizin bilgisayarınızdan erişilir; bu durumda uyarı zararsızdır.

Çözüm: Sunucuyu ağdaki başka cihazlara açacaksanız (--host 0.0.0.0) mutlaka bir API anahtarı verin; istemciler bu anahtarı Authorization başlığında gönderir.

Terminal
llama-server -hf ggml-org/gemma-3-4b-it-GGUF --host 0.0.0.0 --api-key gizli-anahtariniz

Güncelleme ve kaldırma

Güncelleme

Hazır derlemede yeni sürümün paketini (Linux CUDA'da cudart paketiyle birlikte) yeni bir klasöre açıp eskisini silmeniz yeter; indirdiğiniz modeller ~/.cache/huggingface altında durduğu için etkilenmez. Windows'ta winget upgrade llama.cpp, macOS ve Linux'ta Homebrew ile kurduysanız brew upgrade llama.cpp kullanın.

Kaldırma

Hazır derleme kurulum gerektirmez: Açtığınız klasörü silin (ör. rm -rf ~/llama.cpp). İndirilen modeller için ~/.cache/huggingface/hub altındaki models--ggml-org--… klasörlerini silin. Resmî betikle kurduysanız ~/.llama-app klasörünü ve ~/.local/bin/llama dosyasını silin.

Disk alanı

Linux CUDA derlemesi cudart paketiyle 1,1 GB tutar; yalnız işlemci için olan paket 21 MB indirilir. 4 milyar parametreli bir model Q4 kuantizasyonla 2,5 GB, görsel anlama dosyasıyla 3,2 GB yer kaplar.

Lisans ve ticari kullanım

Açık kaynak MIT Ticari kullanım koşullu

OSI onaylı lisans: kodu kullanabilir, değiştirebilir ve dağıtabilirsiniz.

llama.cpp'nin kodu MIT lisanslıdır: Ticari projeler dahil ücretsiz kullanabilir, değiştirebilir ve dağıtabilirsiniz. Çalıştırdığınız GGUF modellerinin lisansı ayrıdır ve Hugging Face'teki model sayfasında yazar: Gemma modelleri Google'ın kullanım koşullarına, Llama modelleri ticari kullanımı koşula bağlayan Llama Community License'a tabidir; Qwen modellerinin çoğu Apache-2.0'dır.

Bu bölüm bilgilendirme amaçlıdır, hukuki görüş değildir. Ticari bir işte kullanmadan önce yazılımın ve indirilen modelin lisans metnini okuyun.

Alternatifler

Jan

Apache-2.0

Model indirme, sohbet ve ayarları tek pencerede toplayan, ChatGPT benzeri ücretsiz ve açık kaynak masaüstü uygulaması.

  • Ekran kartı olmadan da çalışır
  • Kurulum: Kolay
Aktif geliştiriliyor 45,1 bin

Ollama

MIT

Gemma, Qwen, DeepSeek ve Llama gibi açık dil modellerini tek komutla indirip bilgisayarınızda çalıştıran ücretsiz model sunucusu.

  • Ekran kartı olmadan da çalışır
  • Kurulum: Kolay
Aktif geliştiriliyor 184,7 bin

Open WebUI

Open WebUI License

Ollama ve diğer yerel modellere ChatGPT benzeri, Türkçe kullanılabilen bir tarayıcı arayüzü kazandıran açık kaynak sohbet platformu.

  • Ekran kartı olmadan da çalışır
  • Kurulum: Orta
Aktif geliştiriliyor 156,7 bin

Bununla devam edin

llama.cpp ile çalışan modeller

llama.cpp hakkında sık sorulan sorular

llama.cpp ile Ollama arasındaki fark nedir?

Ollama, llama.cpp motorunu kullanır ve model indirme, ayar ve sürüm işlerini sizin yerinize yapar. llama.cpp'yi doğrudan kullandığınızda katman sayısı, bağlam boyutu ve kuantizasyon gibi her ayarı kendiniz seçersiniz ve yeni modeller çoğunlukla önce buraya gelir. Kolaylık için Ollama, denetim için llama.cpp.

4 GB ekran kartı işlemciye göre ne kadar hızlı?

Model sığarsa yaklaşık dört kat. RTX 3050 Laptop (4 GB) ve Ryzen 5 5500U ile Gemma 3 4B yalnız işlemcide saniyede 12–13 belirteç, bütün katmanlar ekran kartındayken 52 belirteç üretti. Ama kartta başka uygulamalar yer tutarken model işlemciye kaydı ve otomatik yerleştirmede hız 10 belirtece, yani işlemci düzeyine indi. Kartı boş tutmak, ayar değiştirmekten daha çok fark yaratıyor.

Rehberlerdeki localhost:8080 adresi neden açılmıyor?

llama-server v0.7.0 ile varsayılan portunu 8080'den 9931'e taşıdı. Tarayıcıda http://127.0.0.1:9931 adresini açın ya da eski adresi kullanmak için sunucuyu --port 8080 ile başlatın. Docker imajları kapsayıcı içinde 8080'i kullanmaya devam ediyor.

Hangi model dosyasını indirmeliyim?

llama.cpp GGUF biçimindeki modelleri çalıştırır. Hugging Face'te ggml-org hesabı popüler modellerin denenmiş GGUF sürümlerini yayımlar. 4–8 GB VRAM ya da 8–16 GB RAM için Q4_K_M kuantizasyonlu 3–4 milyar parametreli modeller iyi bir başlangıçtır; -hf seçeneği bu dosyayı kendisi seçer.